主流汽车市场正在成为车机芯片竞争的主战场,而这里的竞争规则也在改变。
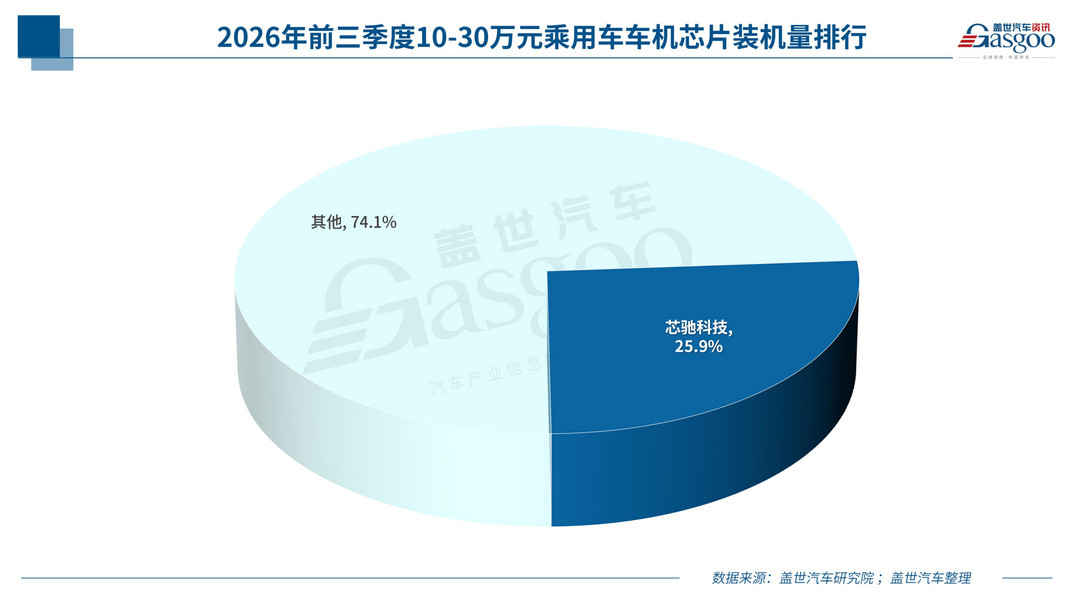
据盖世汽车研究院最新配置数据,2026年前三季度,在国内10万-30万元乘用车市场,芯驰车机芯片(涵盖中控主机与座舱域控)装机量达35.3万颗,在中国大陆本土供应商中排名第一,占该统计口径下本土企业装机总量的约26%。
这份成绩建立在既有车机产品的量产基础上。如今,大模型加速进入汽车座舱,更复杂的计算任务正在改变车企对芯片的要求。从满足传统车机功能,到支持端侧AI运行,芯片企业需要解决的已不只是性能升级,还有如何控制新增的系统成本。
对于已经在主流市场形成装车规模的芯驰而言,下一轮竞争由此展开。更加显而易见的是,芯驰的储备已经先于发令枪到位。
30余万颗背后,规模化装车意味着什么?
一颗芯片能够进入多少辆车,往往取决于性能参数之外的许多因素。
尤其在主流汽车市场,车机芯片不仅需要满足日常功能,还要适应整车开发周期、软件适配要求和长期供货安排。对于销量较大的车型,单颗芯片的成本差异随着交付规模增加,也会成为不可忽视的因素。
这些要求体现在芯驰的具体配套中。
在中控主机领域,芯驰已经进入上汽大众、东风本田及奇瑞等车企的主力车型。据盖世汽车研究院最新配置数据,2026年1-9月,仅上汽大众朗逸的相关芯片配套量就超过11万颗。
对于这类车型而言,相比一味追求更高的计算性能,芯片的成本、运行稳定性及长期软件维护能力,同样影响着车企的选择。
随着座舱架构向域控集中,芯片需要承担的任务也更加复杂。
在奇瑞捷途X70 PLUS、捷途大圣及北汽新能源极狐等车型上,芯驰已经实现座舱域控芯片的规模化配套。与中控主机相比,座舱域控通常需要协调更多显示、交互及车内应用任务,对计算资源分配和软硬件协同提出了不同要求。
从中控主机到座舱域控,应用范围的扩大,也意味着芯片供应商需要适应更多整车平台。不同车企的系统架构、操作系统和功能配置各有差异,相应的软件适配与系统验证工作需要在具体项目中完成。
据芯驰公开信息,其全系列车规芯片累计出货量已突破1500万片,覆盖170多款车型。持续参与整车开发与量产交付,使芯驰积累了跨平台适配、客户协同及工程验证经验。
而随着大模型进入汽车座舱,既有的计算资源配置开始面临新的挑战:当传统信息娱乐系统需要承载更复杂的AI任务,原有算力是否还够用?
大模型上车,算力这笔账怎么算?
过去,车机语音交互主要围绕导航、空调、娱乐等具体功能展开。随着大模型进入座舱,汽车开始能够理解更复杂的自然语言需求,例如规划包含充电、用餐和休息的行程,或者通过连续对话完成多项设置。
这类功能正加速进入主流市场。以15万元级别的全新深蓝S07 AI激光版为例,其搭载的豆包大模型已支持自然语言行程规划、复杂语音交互等功能。
要知道,根据乘联分会数据,2026年前三季度,10万-20万元乘用车占国内零售市场的41.9%,是销量最大的单一价格带。随着AI功能进入这一市场,车企既要持续升级智能化体验,也需要控制由此增加的硬件和开发成本。
用户感受到的是交互方式的变化,车企还需要决定这些功能究竟由哪里计算。
复杂知识问答、内容生成等任务可以借助云端资源;需要快速响应、处理本地信息或降低网络依赖的功能,则更适合在车端运行。端云如何分工,直接影响本地算力的配置。
即便确定了哪些模型需要部署在车端,计算平台仍然不能只看NPU算力。
模型运行需要内存保存参数,推理过程依赖访存带宽,导航、娱乐及多屏显示等功能还要与AI任务共享资源。车企增加本地算力时,存储、功耗、散热及系统成本通常也需要重新考虑。
现阶段,一种方案是在原有座舱SoC之外增加独立AI Box,专门承担模型计算任务。这种方式适合部分成熟平台升级,可以保留既有座舱架构,减少对原系统的改动,也便于AI计算模块相对独立地迭代。新增设备则需要相应的内存、供电、散热和软件协同支持。
对于重新开发的座舱平台,车企也可以选择集成度更高的SoC,将传统座舱计算与AI推理集中在一颗芯片上。这样有机会减少外围硬件,同时要求芯片具备更强的并发处理、带宽分配和功耗控制能力。
两种技术路线各有适用条件。对于车企而言,选择座舱计算平台时,需要综合考虑芯片采购、外围器件、软件开发及系统验证等投入,而不只是比较算力参数。
对于芯片供应商,竞争也由此从提供更高的峰值算力,延伸至如何以合理的系统成本,支持更多AI功能在整车上落地。
从X9到X10,芯驰的答案是什么?
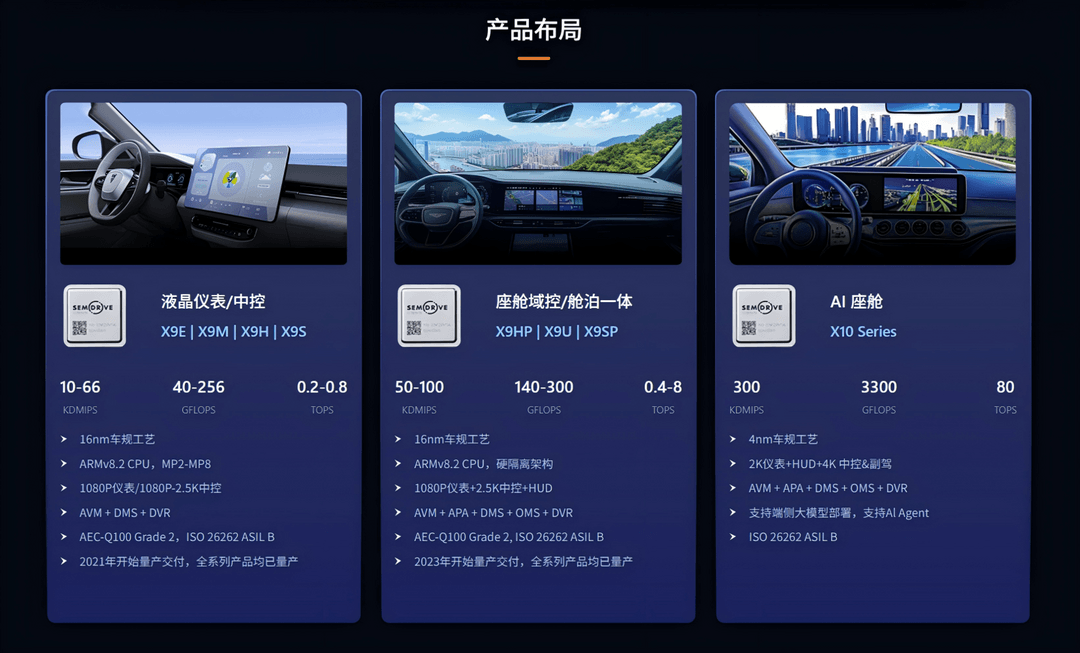
面对座舱计算需求的变化,芯驰已经形成覆盖不同层级的产品布局。
从早期产品定义阶段便引入NPU的X9系列,到将NPU算力提升至8 TOPS的X9SP,再到面向端侧大模型的X10,其产品并非简单的代际替代,而是对应不同层次的计算需求。
图片来源:芯驰
其中,X10需要应对更加复杂的任务:在运行端侧大模型的同时,保证多屏显示、信息娱乐等传统座舱功能正常工作。这要求芯片不仅具备更高的AI算力,还要能够合理分配不同任务所需的计算资源。
根据芯驰官网公布的产品参数,X10采用4nm车规工艺,CPU性能达到300 KDMIPS,GPU性能为3300 GFLOPS,NPU算力达到80 TOPS,内存带宽为154 GB/s,支持最高9B参数规模的大模型端侧部署,并针对MoE模型的专家动态路由进行了架构优化。
这些参数中,内存带宽尤其值得关注。大模型推理需要频繁读取模型参数,如果数据传输跟不上,计算单元就可能因等待数据而无法充分发挥性能。尤其当AI推理与多屏显示、信息娱乐等任务同时运行时,内存带宽与资源调度能力会直接影响系统效率。
因此,X10并非单纯提高NPU算力,而是通过CPU、GPU、NPU与内存系统的协同,在支持大模型推理的同时兼顾传统座舱应用。
除了计算能力,系统集成也是X10的重要设计方向。
前文提到,车企可以通过外挂AI Box增加端侧计算能力。X10则将座舱计算与大模型推理整合到单颗芯片中,在满足相应功能需求的条件下,替代传统“座舱SoC+外挂AI Box”组合方案。
按照芯驰公布的方案测算,相较于传统组合架构,X10可减少约25%的DDR存储容量,使整体系统BOM成本有望降低1500—3000元。同时,通过工艺与架构优化控制功耗,X10支持风冷散热,减少对复杂散热系统的依赖。
不过,硬件集成并不意味着软件开发工作可以省略。大模型上车仍涉及模型移植、算子适配、性能调优,以及与既有座舱软件的协同。
围绕X10,芯驰提供标准化模型调用接口、主流开源模型预适配及定制化优化支持,以减少开发过程中的重复工作。在不同平台之间,芯驰也支持客户先基于X9开展原型开发,再向X10迁移,复用部分既有开发成果。
从计算资源协同、系统集成到软件适配,X10的产品设计已经不局限于单颗芯片的性能提升,而是进一步考虑整套座舱计算方案的部署效率与系统成本。
截至目前,X10也已进入商业化落地阶段。据芯驰此前披露的信息,X10已与多家车企达成量产合作。
AI SoC的竞争边界,正在走出汽车
在新一代AI座舱芯片之外,芯驰的产品布局也开始向汽车以外的智能终端延伸。
具身智能与智能汽车在多模态感知、模型推理、实时控制等方面存在一定的技术共性,为汽车芯片企业拓展机器人业务提供了空间。
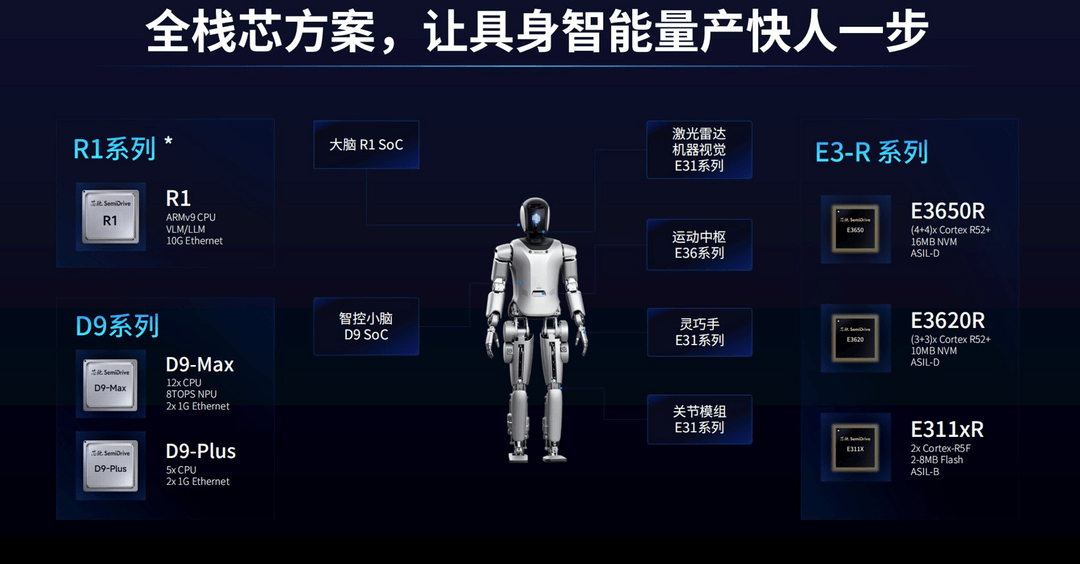
2026年北京车展期间,芯驰正式宣布战略2.0升级,将业务布局从汽车智能扩展至通用智能,并推出R1、D9及E3-R系列芯片,分别面向大模型推理、运动规划与实时控制,以及躯干、关节等执行控制需求。
图片来源:芯驰
与汽车座舱不同,机器人不仅需要完成感知和模型计算,还必须将计算结果转化为具体动作,对运动控制、实时响应及不同计算单元之间的协同提出了新的要求。
芯片厂商也因此需要提供更完整的控制器方案及软件开发支持。
芯驰与瑞莎计算机联合推出的RoboX D9M,便是这一布局的具体进展。
这款基于D9-Max打造的机器人小脑控制器,除硬件外,还提供参考设计与开源软件栈,帮助开发者减少底层系统搭建工作。
值得注意的是,芯驰官网披露,其D9系列芯片已在头部具身智能厂商实现量产。
在合作生态方面,芯驰还与阿帕奇机器人围绕大小脑控制器及关节模组开展联合开发,并与银河通用在机器人芯片、控制系统及工具链等领域展开合作。
从既有车机芯片的规模化装车,到X10面向端侧AI的计算与系统集成,再到机器人控制器和开发生态,芯驰的产品应用正在不断拓展。
芯片企业的竞争,也随之从单颗产品的性能与成本,进一步延伸到计算架构、软件工具链及不同场景下的适配能力。
对于芯驰而言,规模化装车积累的不只是出货量,还有产品开发、软件适配与工程交付能力。这些能力正在从汽车座舱向更多智能终端延伸,也为芯驰从车规芯片供应商向计算平台提供商拓展业务提供了基础。
来源:第一电动网
作者:盖世汽车
本文地址:https://www.d1ev.com/news/shichang/316378
以上内容转载自盖世汽车,目的在于传播更多信息,如有侵仅请联系admin#d1ev.com(#替换成@)删除,转载内容并不代表第一电动网(www.d1ev.com)立场。
文中图片源自互联网,如有侵权请联系admin#d1ev.com(#替换成@)删除。


先估价再买车,买的放心开的安心
您的询价信息
已经成功提交我们稍后会联系您进行报价!


 京公网安备
11010502033163号
