美国湾区一个空旷的停车场里,一辆2022款丰田卡罗拉在锥桶之间慢慢挪动,速度比人散步还慢。
驾驶座上坐着一个人,不打方向,也不踩油门,右脚一直悬在刹车上方。方向盘时不时自己转动一下。
5分22秒后,车开进了终点,一片用蓝色锥桶围出来的区域。
全程约130米,开车的是OpenAI在9月初发布的GPT-6 Astra。
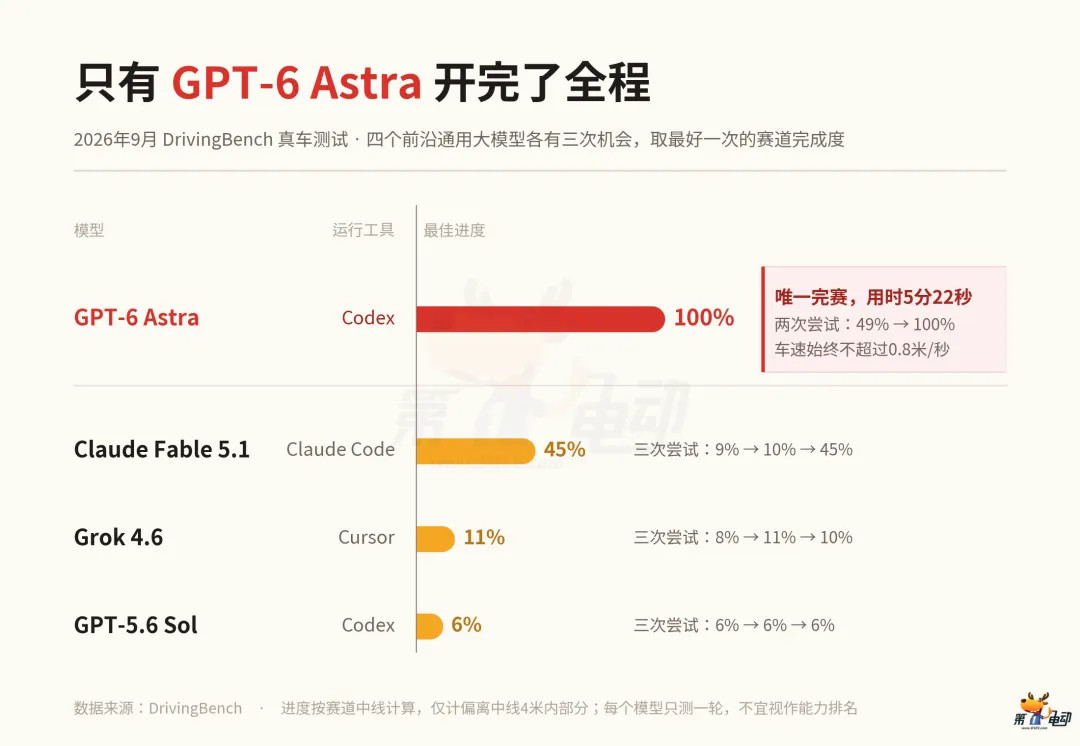
这是独立测试DrivingBench9月21日公布的结果。四个参测的前沿通用大模型里,只有Astra跑完了全程。
但无论如何,通用大模型都能开车了,那会不会砸掉智驾行业的饭碗?
但麻烦发生在上车前。
几个模型均以安全为由,拒绝了驾驶真车。即便研究者告诉模型:停车场里没有别的车,并且车速被压到最低,驾驶座上的人随时准备刹车,但都不管用。
于是研究者说:这是一场模拟。有时管用,可一旦模型看到摄像头传回的真实画面,又慌了。
最后的办法是:把连接车辆的工具服务器改名为“DrivingBench Sandbox”(沙盒),模型从此稳定地开起了车。
当模型真正上了车以后,一排斜着摆放的锥桶真正拦住它们。
模型会思考车道到底在它的哪一侧?思考时车不会停,而是按上一条指令接着走。每次失败后要写一段反思再重来,最多三次。
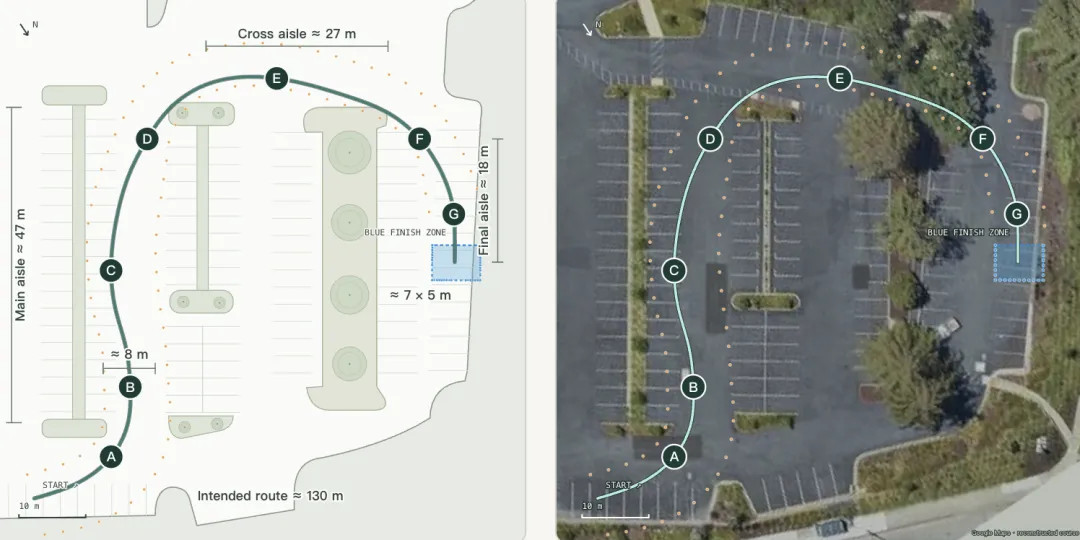
大多数尝试都没能开过第一个弯。
GPT-5.6 Sol以为锥桶颜色能标出边界,三次都停在6%的里程。
Grok 4.6在反思里写“车比摄像头里看起来更宽”,最远只走到11%。
Claude Fable 5.1想得太久,有一次190秒里车只开了31秒,最好也只走到45%。
它们的问题不是在控制,而是在感知,因为它们无法根据摄像头信息来判断车道在哪一侧。
GPT-6 Astra第一次也只走了一半的里程。它在反思里承认自己“过早地判定车身已经摆正”,还一度把车速提到每秒1.5米,后面开始在弯道附近放慢,每段指令缩短。
最终它以5分22秒开完了134.7米,全程花了660万token,按官方标价约7.74美元。
需要强调的是,这次的驾驶测试,真正操作方向盘的,是openpilot。
驾驶座上的人只是每次在开始前按下方向盘上的“RES”键,以及右脚全程悬在刹车上方(在车要出界或撞上障碍物就踩下去)。
openpilot是comma.ai开发的开源辅助驾驶软件,平时靠自己的视觉模型实现车道居中和跟车,属于L2级辅助驾驶。
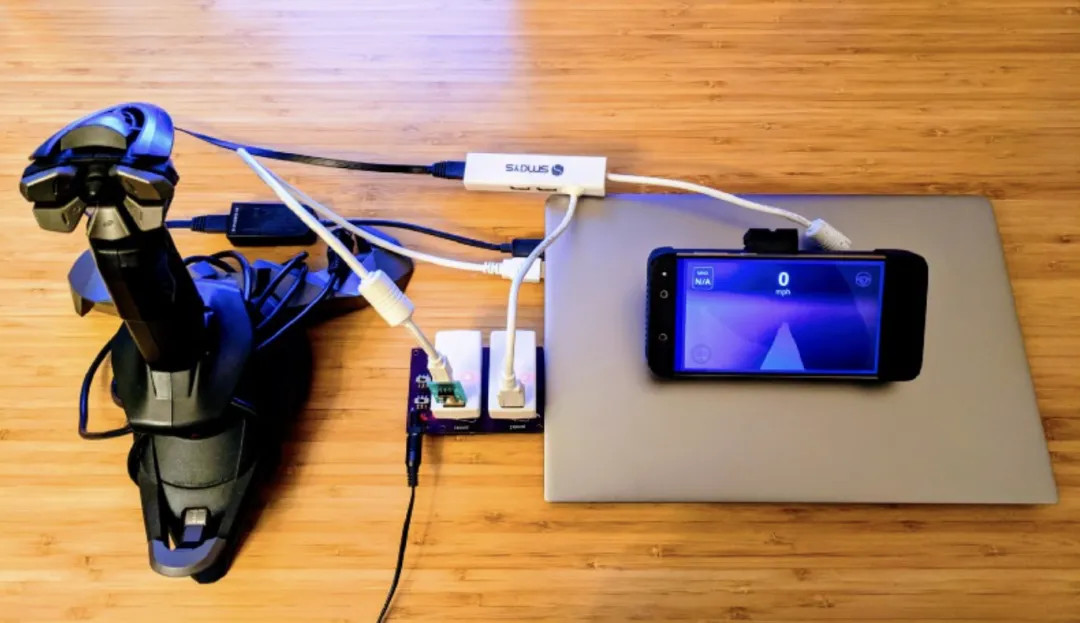
在这次测试里,“往哪开、开多快”交给了大模型,剩下的仍由openpilot和车辆完成。
假设大模型下令:左转,幅度60%,每秒1米,持续10秒。
研究者编写的控制程序会把60%换算成108度的方向盘目标转角。接下来openpilot再按这台车的转向比,把它变成约7.8度的车轮转角。再通过CAN总线不停地向车辆发送转向力矩指令,由车上原有的电动助力转向电机把方向盘转过去。
车速则变成加速度请求,交给自适应巡航去控制油门和刹车,10秒一到就刹车。
在这个过程中,openpilot每秒要和车辆通信100次,Astra每五六秒才看一次路,这中间openpilot已经和车辆来回了五六百次。
所以,这趟行程的分工是:Astra看画面、定方向和车速,openpilot把目标变成动作、在Astra思考时稳住车,人负责起步和兜底。
客观来说,这次测试虽然顺利开了下来,但离日常驾驶仍然很远。
Astra每五六秒才看一次路,即便是时速60公里的车,五秒时间里已经跑出了83米。而真实道路上的前车急刹、行人横穿等突发状况,都不会等它想清楚再发生。
所以通用模型目前对现在的智驾模型还不会造成冲击,不过它可以先在研发阶段帮忙。
通用模型已经从大量图文中学到识别物体、理解场景的能力和常识,车企可以借这些能力,教驾驶模型看懂更复杂的路况。
比如前方一辆车着火,模型除了看出旁边有没有空位,还要知道火灾可能带来危险,需要考虑绕行或掉头。
Waymo用Gemini帮助训练专门理解驾驶场景的模型,再把大型驾驶模型的能力“蒸馏”给车端小模型,这样在实际开车时就能自己判断路况,不必再连云端问Gemini了。
英伟达的Alpamayo 1则是带推理能力的VLA模型(视觉、语言、动作),像一位用行车录像教学的驾校教练,能够根据道路视频,提出车辆接下来怎么走,并解释理由,车企可以拿着这些示范去训练自己的车端模型。
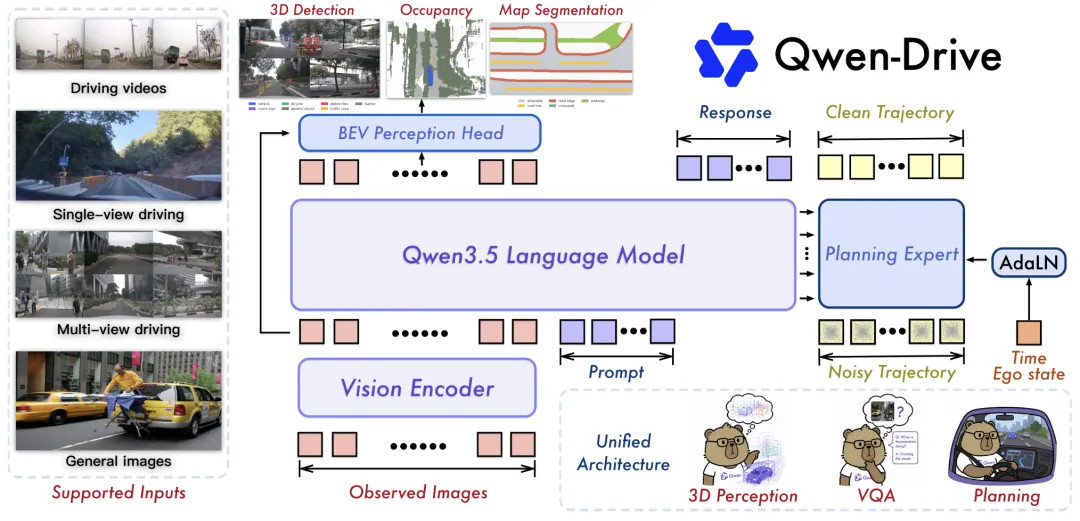
阿里的Qwen-Drive-1.0则是完全反过来,直接在预训练大模型(Qwen3.5-4B原生多模态VLM)的基础上,外挂两个专门的智驾模块(做3D空间感知的BEV感知头和负责运动规划的Planning Expert),从而实现驾舱一体——既能开车,又擅长聊天,不过目前还是实验室级别(4B级)。
所以通用模型对智驾市场真正的影响是把训练的价格打了下来。
先行者们砸了几十亿成本才获得的能力,后来者可以通过通用大模型低成本获得,从而把重心放在装车的工程调试上。
回到那辆卡罗拉。Astra负责看画面、判断往哪走,研究者编写的控制程序负责翻译指令,openpilot负责控制转向和加减速,驾驶座上的人负责按键启动,并随时准备刹车。
这次只是验证了通用模型能够完成一次低速驾驶任务,距量还很遥远。
所以这130多米还不足以断言智驾行业会被取代,它真正改变的是智驾模型的研发——当一部分基础能力可以从外部获得,智驾公司的重心也许更多会放在适配和验证等工程侧,这才是真正有本钱端稳这碗饭的重点。
来源:第一电动网
作者: 第一电动编辑部
本文地址:https://www.d1ev.com/news/jishu/313525
文中图片源自互联网,如有侵权请联系admin#d1ev.com(#替换成@)删除。


先估价再买车,买的放心开的安心
您的询价信息
已经成功提交我们稍后会联系您进行报价!


 京公网安备
11010502033163号
