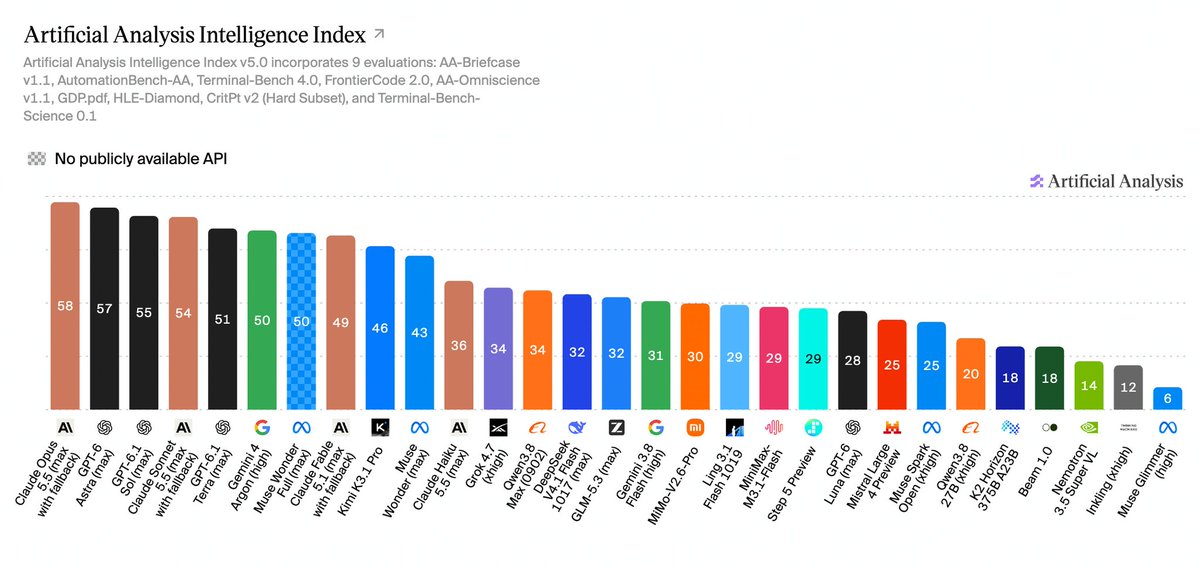
10月29日,ArtificialAnalysis发布IntelligenceIndexv5,这是该机构自2026年1月v4上线以来幅度最大的一次基准重构。v5最直接的变化是60%的评测权重首次建立在私有测试集或隐藏答案之上,用于压缩公开题库被模型训练数据污染的空间,减少各厂商为跑分而跑分的注水测试项目。该指数仍由九项评测构成,知识工作、编码、科学、通用能力各占25%。其中编码25%的权重里,Cognition同日发布的FrontierCode2.0独占15%,Terminal-Bench4.0占10%。
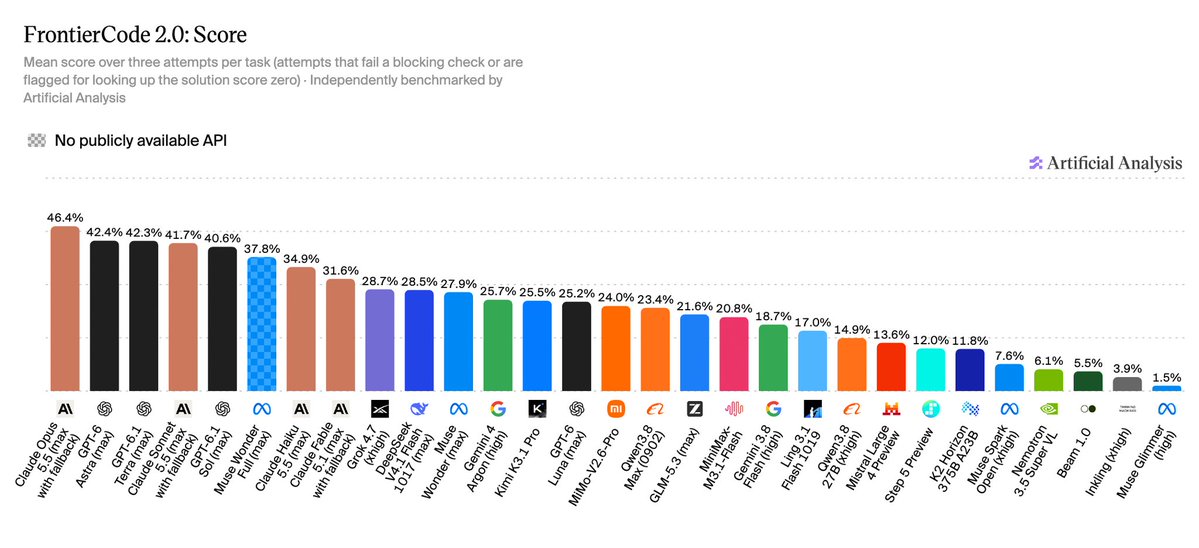
FrontierCode2.0完全换了一套评分逻辑。132项任务全部来自真实开源仓库,模型提交的代码改动不再只由单元测试是否通过来判定,而是由仓库维护者按是否愿意合并这个PR来打分,任何一项阻塞性检查失败即记零分。在这一口径下,DeepSeekV4.1-Flash1017(max)在FrontierCode2.0上录得28%,是所有已发布权重模型中得分最高的一个。KimiK3.1Pro以25.5%紧随其后,但其完整权重要到11月4日前才发布,AA在v5报告中将其标注为weightsnotyetreleased。
谷歌Gemini4Argon(high)为25.7%,GPT-6Luna为25.2%,均低于DeepSeekV4.1Flash。在IntelligenceIndexv5综合得分上,DeepSeekV4.1Flash与GLM-5.3同为32分,仍落后榜首ClaudeOpus5.5(58分)26分,且低于ClaudeHaiku5.5的36分。
ArtificialAnalysis指出,v5真正加剧的是开源与闭源前沿之间的整体距离。v4.3时最强开源模型与榜首差距是3分,v5把大部分公开题换成私有题并加重智能体实战任务比重后,这一差距扩大到12分。KimiK3.1Pro以46分成为名义上最强的开源权重模型,但尚未发布权重;已发布权重的模型中32分是当前天花板。差距在HLE-Diamond和Terminal-Bench-Science两项上最为刺眼,KimiK3.1Pro分别为37%和34%,而ClaudeOpus5.5在HLE-Diamond上为68%,GPT-6Astra在Terminal-Bench-Science上为63%。另一个被放大的变量是努力值的成本优势,ClaudeOpus5.5从低努力档到max档跨越23分,单任务成本从0.98美元升至10.04美元,相差约10倍。在得分最高的十款模型中,GPT-6.1Terra每任务成本最低为0.96美元,ClaudeFable5.1最高为13.04美元,相差超过13倍。与v5同步推出的ProgressIndexv1则将2022年11月以来发布的主要语言模型映射到一个连续的能力尺度上,用于观察能力随时间如何演进。
来源:一电快讯
返回第一电动网首页 >
以上内容由AI创作,如有问题请联系admin#d1ev.com(#替换成@)沟通,AI创作内容并不代表第一电动网(www.d1ev.com)立场。
文中图片源自互联网或AI创作,如有侵权请联系邮件删除。


 京公网安备
11010502033163号
