10月28日,英伟达宣布推出开放权重语音转录模型Nemotron3.5Transcribe,并同步公开训练数据管线Granaryv2。该模型整合转录、说话人归属、翻译和音频问答功能,主要面向会议纪要、课堂录像、访谈整理和多语言客服等场景,目前已在HuggingFace与ModelScope免费开放,采用OpenMDW-1.1许可证。
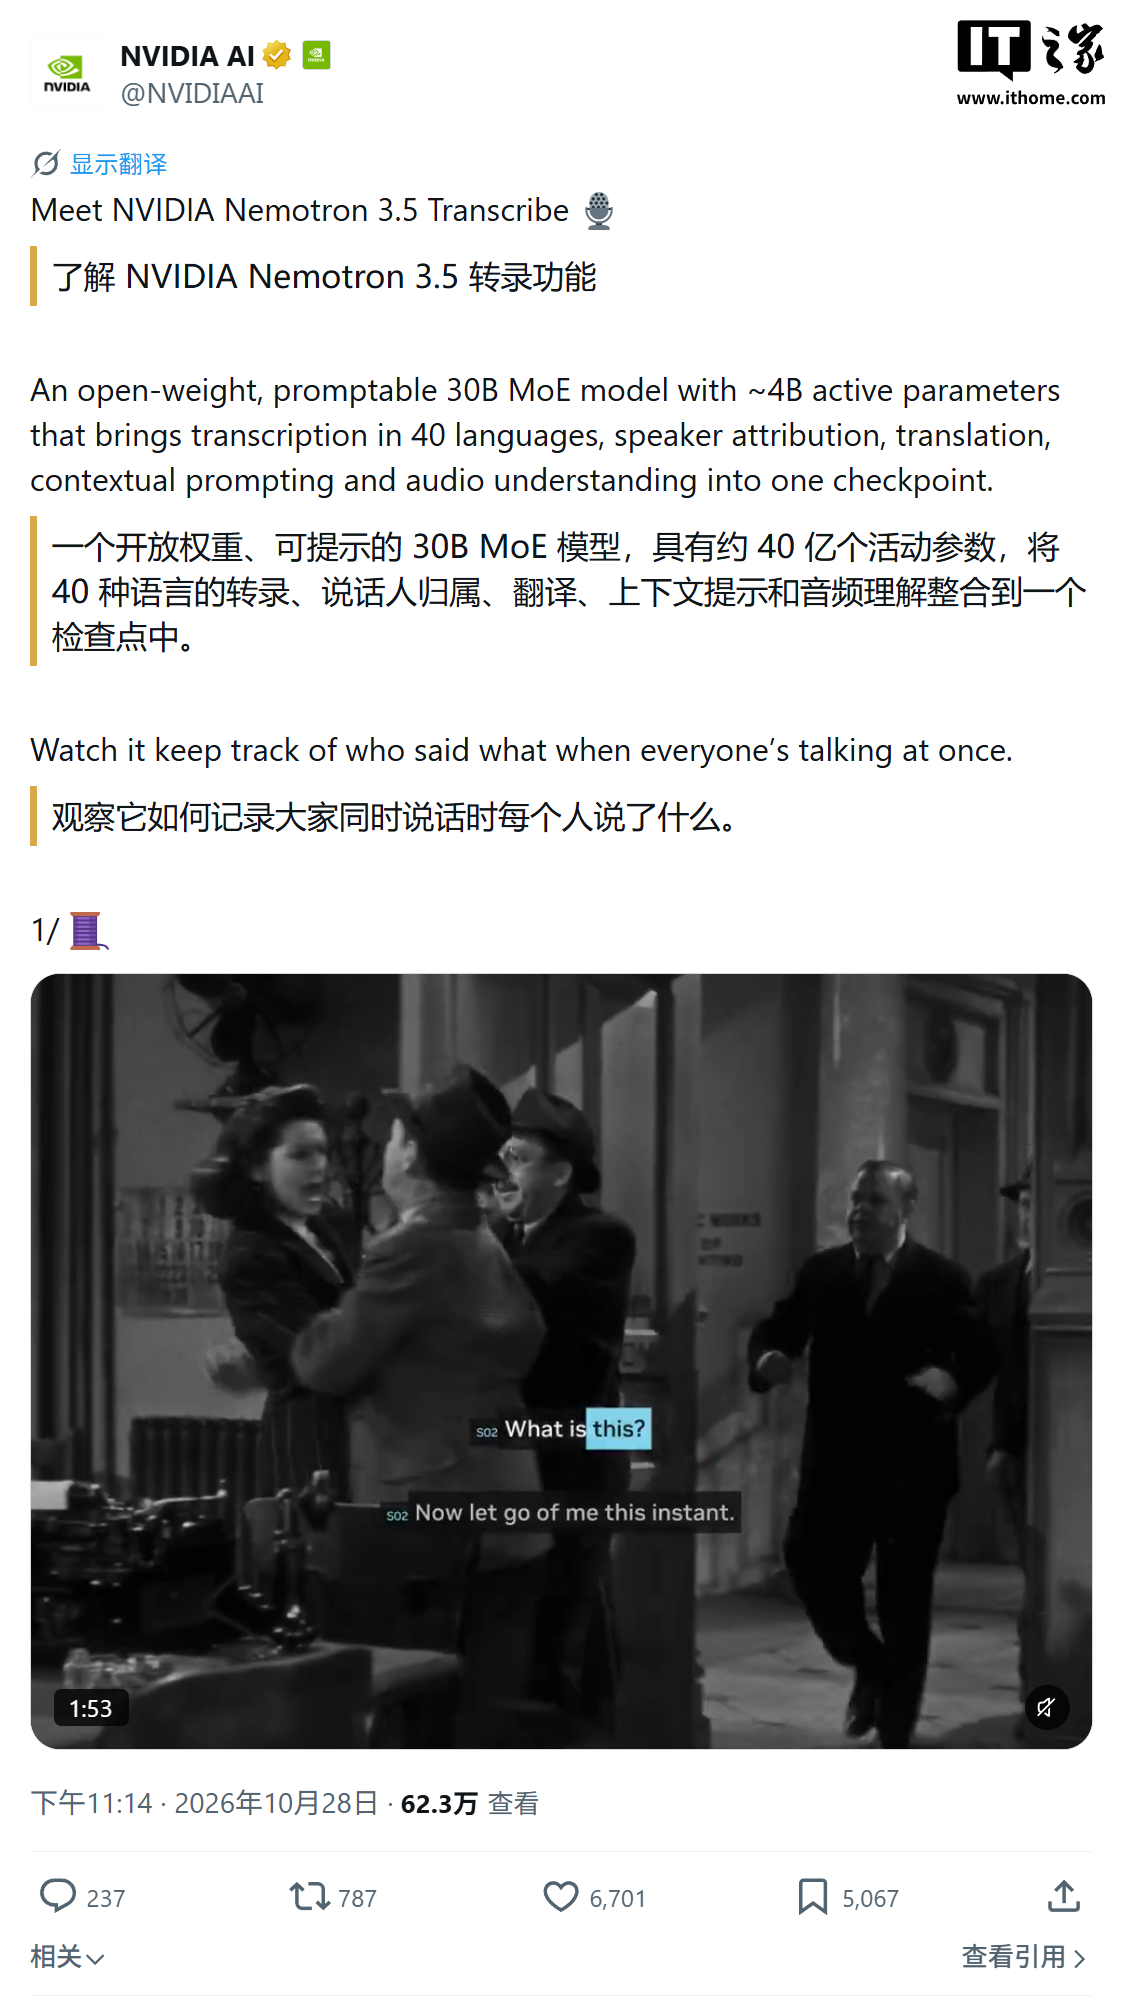
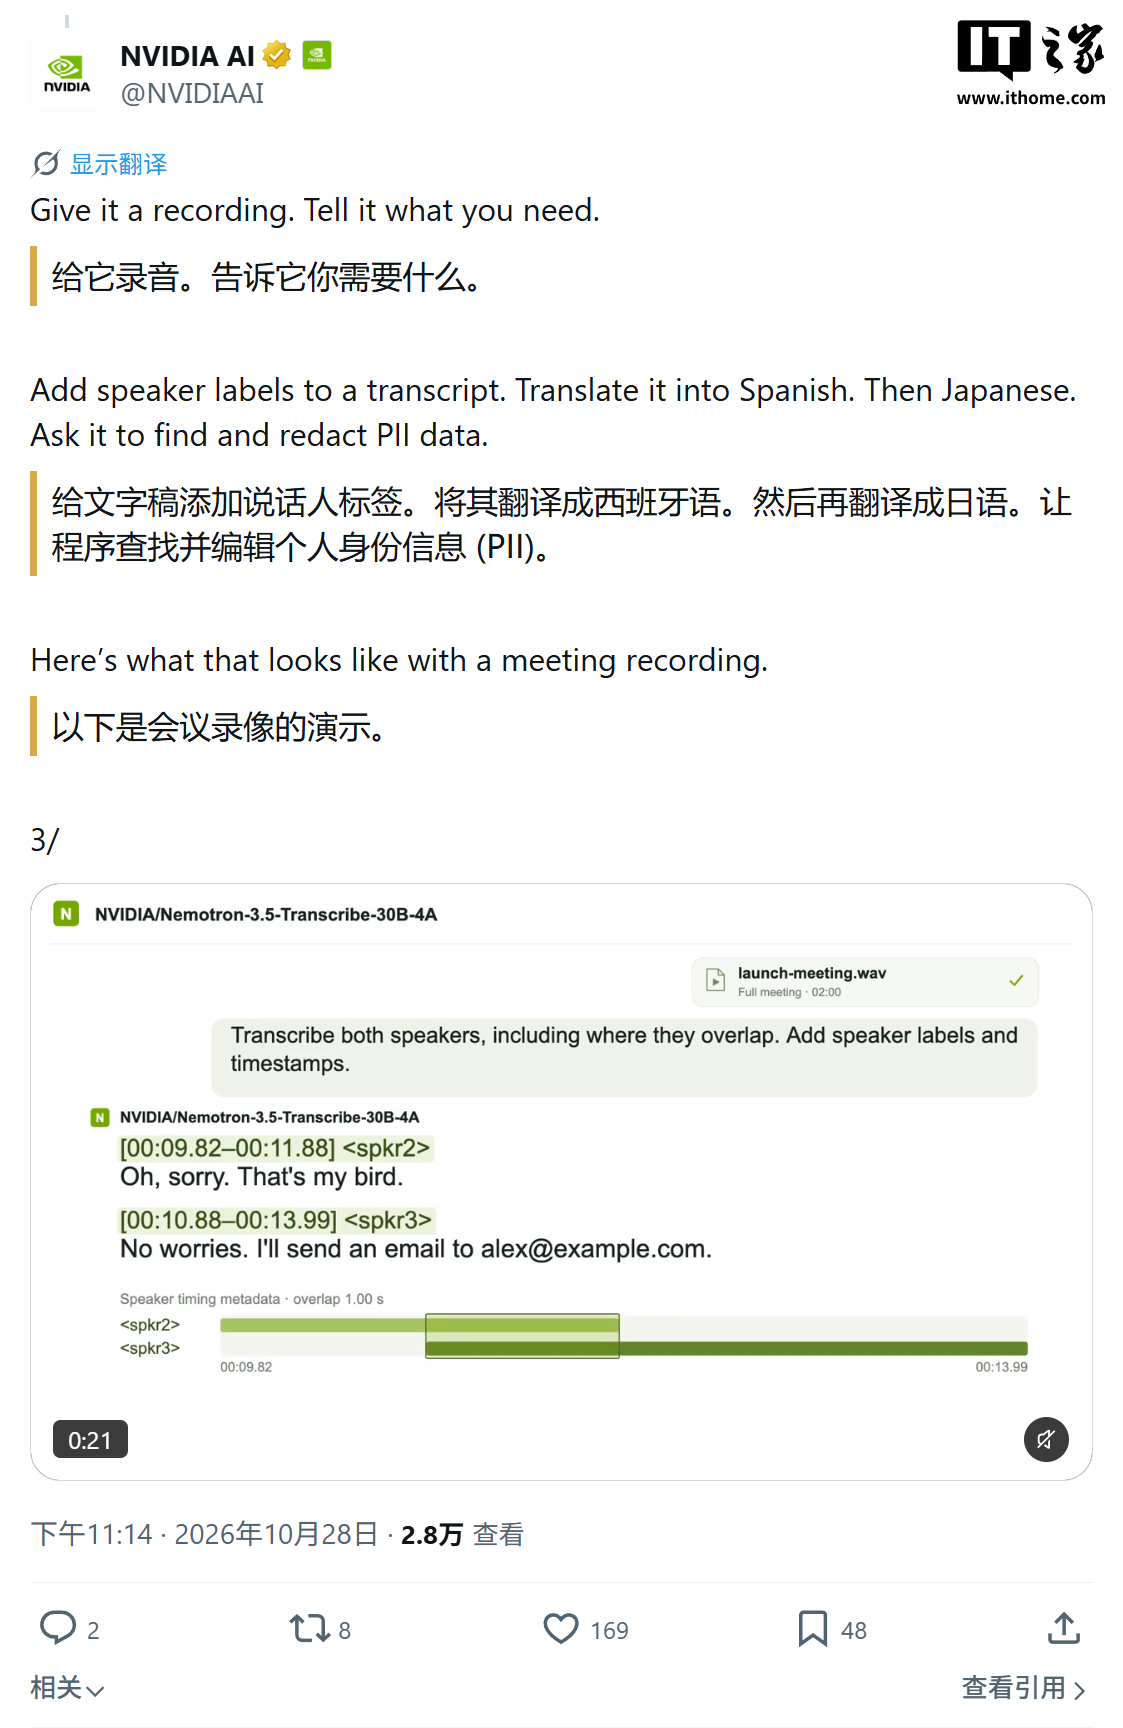
在架构方面,Nemotron3.5Transcribe采用混合专家架构,总参数约340亿,激活参数量约43亿。它可处理最长1小时的录音,支持40种语言的转录,其中31种语言可与英语互译;说话人识别方面最多可区分8名说话人,并支持13种语言的说话人标注。该模型最大亮点是应对多人同时说话的能力,在生成文本时即可为每段发言标注说话人,官方演示中对1940年电影《他的女友礼拜五》语速极快、大量重叠对白的场景也能分角色生成字幕。
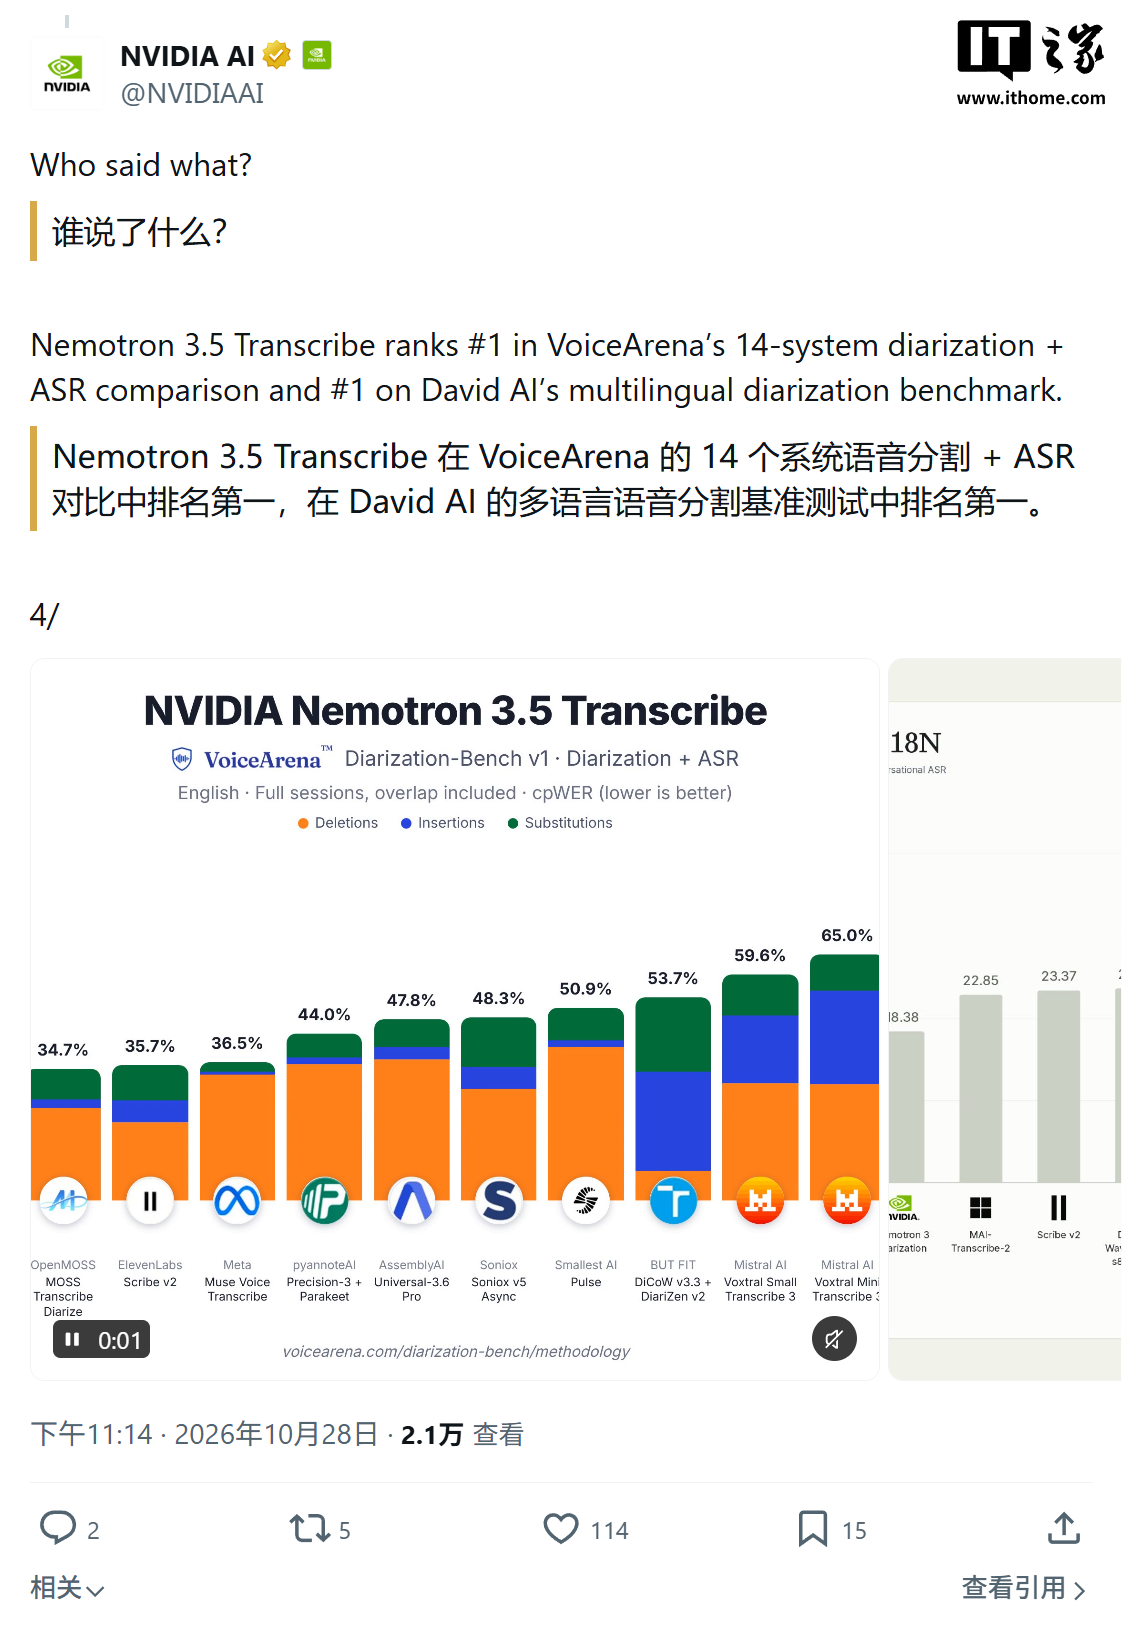
在公开评测中,该模型在HuggingFaceOpenASRLeaderboard英语组以5.33%的平均词错误率位居开放权重模型第一,在ArtificialAnalysis的非流式词错误率指数中以2.8%的成绩与VoxtralSmallTranscribe并列开源模型首位,并在DavidAI的21种语言说话人分离基准中录得18.26%的最低错误率。同步公开的Granaryv2数据清单覆盖463062小时音频、48种语言、16个源语料库,相比Granaryv1的25种语言明显扩展,可对同一段录音生成逐字稿、含不流畅表达的书面文本和去除不流畅表达的干净文本三种转录变体。量化版本预计后续发布,便于在RTXSpark、DGXSpark、JetsonAGXThor等本地设备运行。
来源:一电快讯
返回第一电动网首页 >
以上内容由AI创作,如有问题请联系admin#d1ev.com(#替换成@)沟通,AI创作内容并不代表第一电动网(www.d1ev.com)立场。
文中图片源自互联网或AI创作,如有侵权请联系邮件删除。


 京公网安备
11010502033163号
